Стенограммы совещаний с именами говорящих
После совещания остаётся запись на сотни мегабайт, которую никто не откроет. Через неделю никто не помнит, кто что обещал.
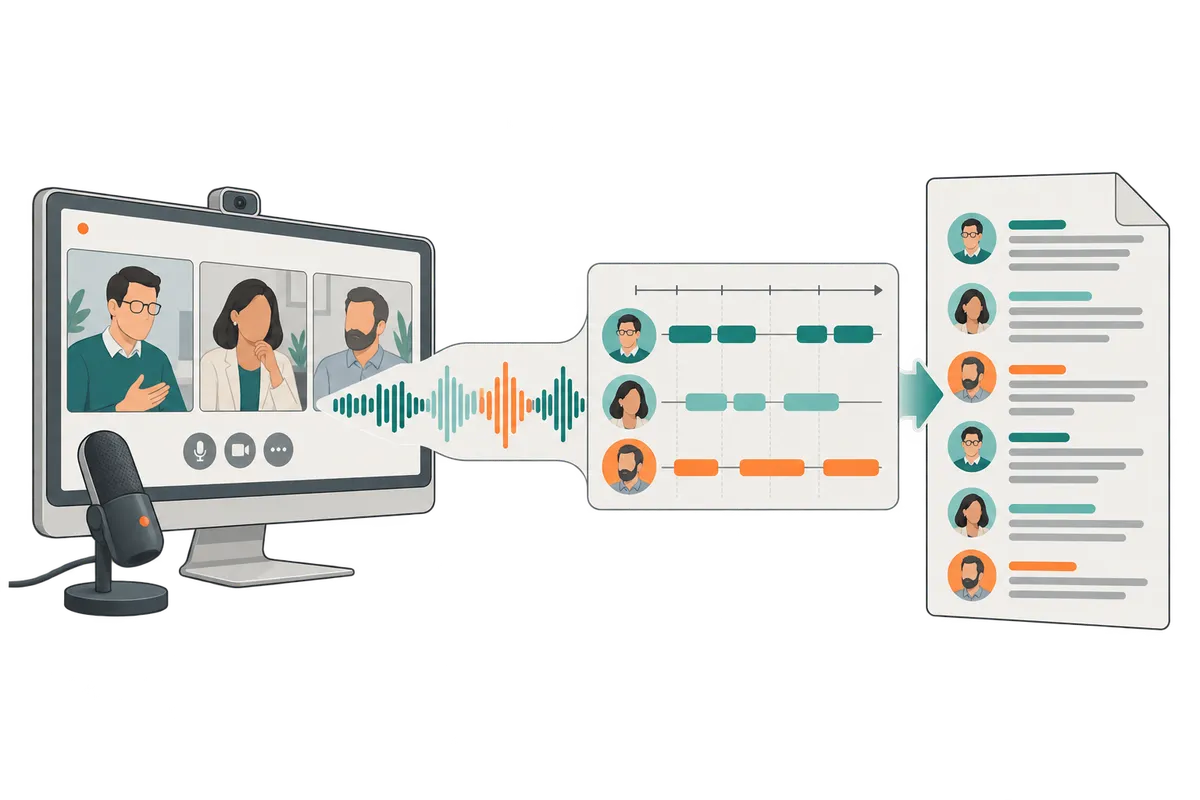
Мы сделали сервис, который превращает запись в текст: реплики с таймкодами, подписанные настоящими именами участников, и человекочитаемый файл приходит в рабочий чат через несколько минут после встречи.
Как устроено
Две части на разных машинах:
Наблюдатель сидит рядом с записями: находит готовую встречу, отправляет звук на распознавание, склеивает имена, правит термины, пишет файлы и отправляет протокол в чат.
Распознаватель живёт на машине с видеокартой: держит очередь заданий, поднимает faster-whisper под задачу и выгружает модель после — карта нужна не только ему. На выходе — реплики с временем каждого слова.
Отдельный бот сидит в комнате совещаний служебным участником и ведёт журнал: кто и когда говорил. Медиа он не публикует и людям не мешает.
Где вся сложность
Не в распознавании — оно давно решённая задача. Сложность в том, чтобы подписать реплики правильными именами.
Часы не совпадают. Журнал говорящих начинается по событию о старте записи, которое приходит с задержкой в несколько секунд. Обе шкалы приходится выравнивать по разнице между временем в имени файла и первой записью журнала.
Признак говорящего запаздывает. Событие dominantSpeaker в Jitsi переключается не мгновенно — измеренная задержка три-четыре секунды. Границу приходится подтягивать назад, к настоящему началу речи.
Реплика может лежать на границе. Если фрагмент начался у одного человека, а закончился у другого, он режется по границе — по таймкодам слов. Именно поэтому распознавание обязано возвращать время каждого слова, а не только фразы.
Журнал не нашёлся — работа не останавливается: текст выходит без имён, с честной пометкой в шапке.
Урок, который стоил половины протокола
Изначально в распознавание подмешивался словарь технических терминов через initial_prompt — казалось, что так модель точнее распознает названия систем. Первое настоящее совещание показало обратное: больше половины стенограммы оказалось повторяющимся мусором из слов самого словаря, а живой речи осталось меньше четверти.
Измерили: один и тот же звук через пять вариантов списка. Без словаря — тысяча четыреста слов живой речи, со словарём — двести семьдесят. Восемьдесят процентов разговора просто исчезло, вместо него модель по кругу писала названия систем, которые на встрече ни разу не прозвучали.
Словарь выключили навсегда, а исправление коверканных названий сделали иначе — заменами в уже готовом тексте, где ничего исчезнуть не может.
Что это даёт
Через несколько минут после встречи в чате лежит протокол: кто что сказал, с временем. Искать по нему можно текстом, а не перематывая запись.