Резервирование и восстановление
Две разные задачи, которые часто путают: чтобы система пережила отказ железа — и чтобы бизнес пережил потерю площадки.
Отказоустойчивость
- Дублирование узлов и служб, распределение по разным физическим машинам и зонам.
- Балансировка и health check, чтобы трафик уходил с упавшего узла автоматически.
- Кластеры баз с переключением на реплику и понятной процедурой возврата.
Резервные копии
- Копии на отдельной площадке, а не на том же сервере и не на том же хранилище.
- Расписание и сроки хранения под требования: суточные, недельные, месячные.
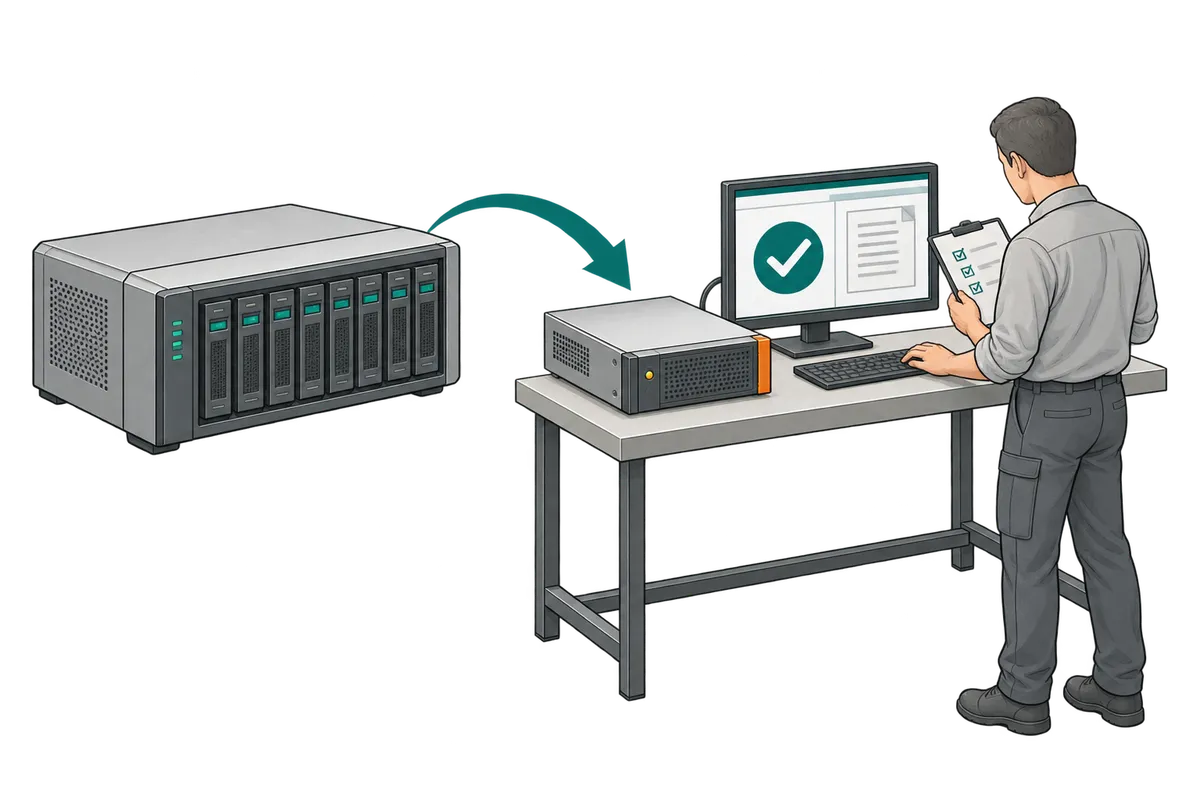
- Регулярное восстановление на тестовый контур. Пока копию не развернули — неизвестно, копия это или набор байтов.
План восстановления
Документ, в котором записано: какие системы поднимаем первыми, кто это делает, за какое время и что считается «поднялись». Проверяется учениями, а не хранится в папке до первой аварии.
Две величины, которые определяют схему и её стоимость:
- RPO — сколько данных допустимо потерять: от нуля до суток;
- RTO — сколько времени допустимо лежать: от минут до рабочего дня.
Обе цифры называет бизнес, а не инженеры. Дальше под них подбирается схема.
Что получает заказчик
Проверенную процедуру восстановления с измеренным временем — вместо надежды, что бэкапы, которые никто не открывал, окажутся рабочими.