Кубер, который нельзя было масштабировать
Что было
Крупный туроператор Казахстана. Работающая платформа с публичными сайтами и API. К моменту нашего появления она целиком жила на собственном железе: кластер Kubernetes собран на виртуальных машинах, поднятых на своих же гипервизорах.
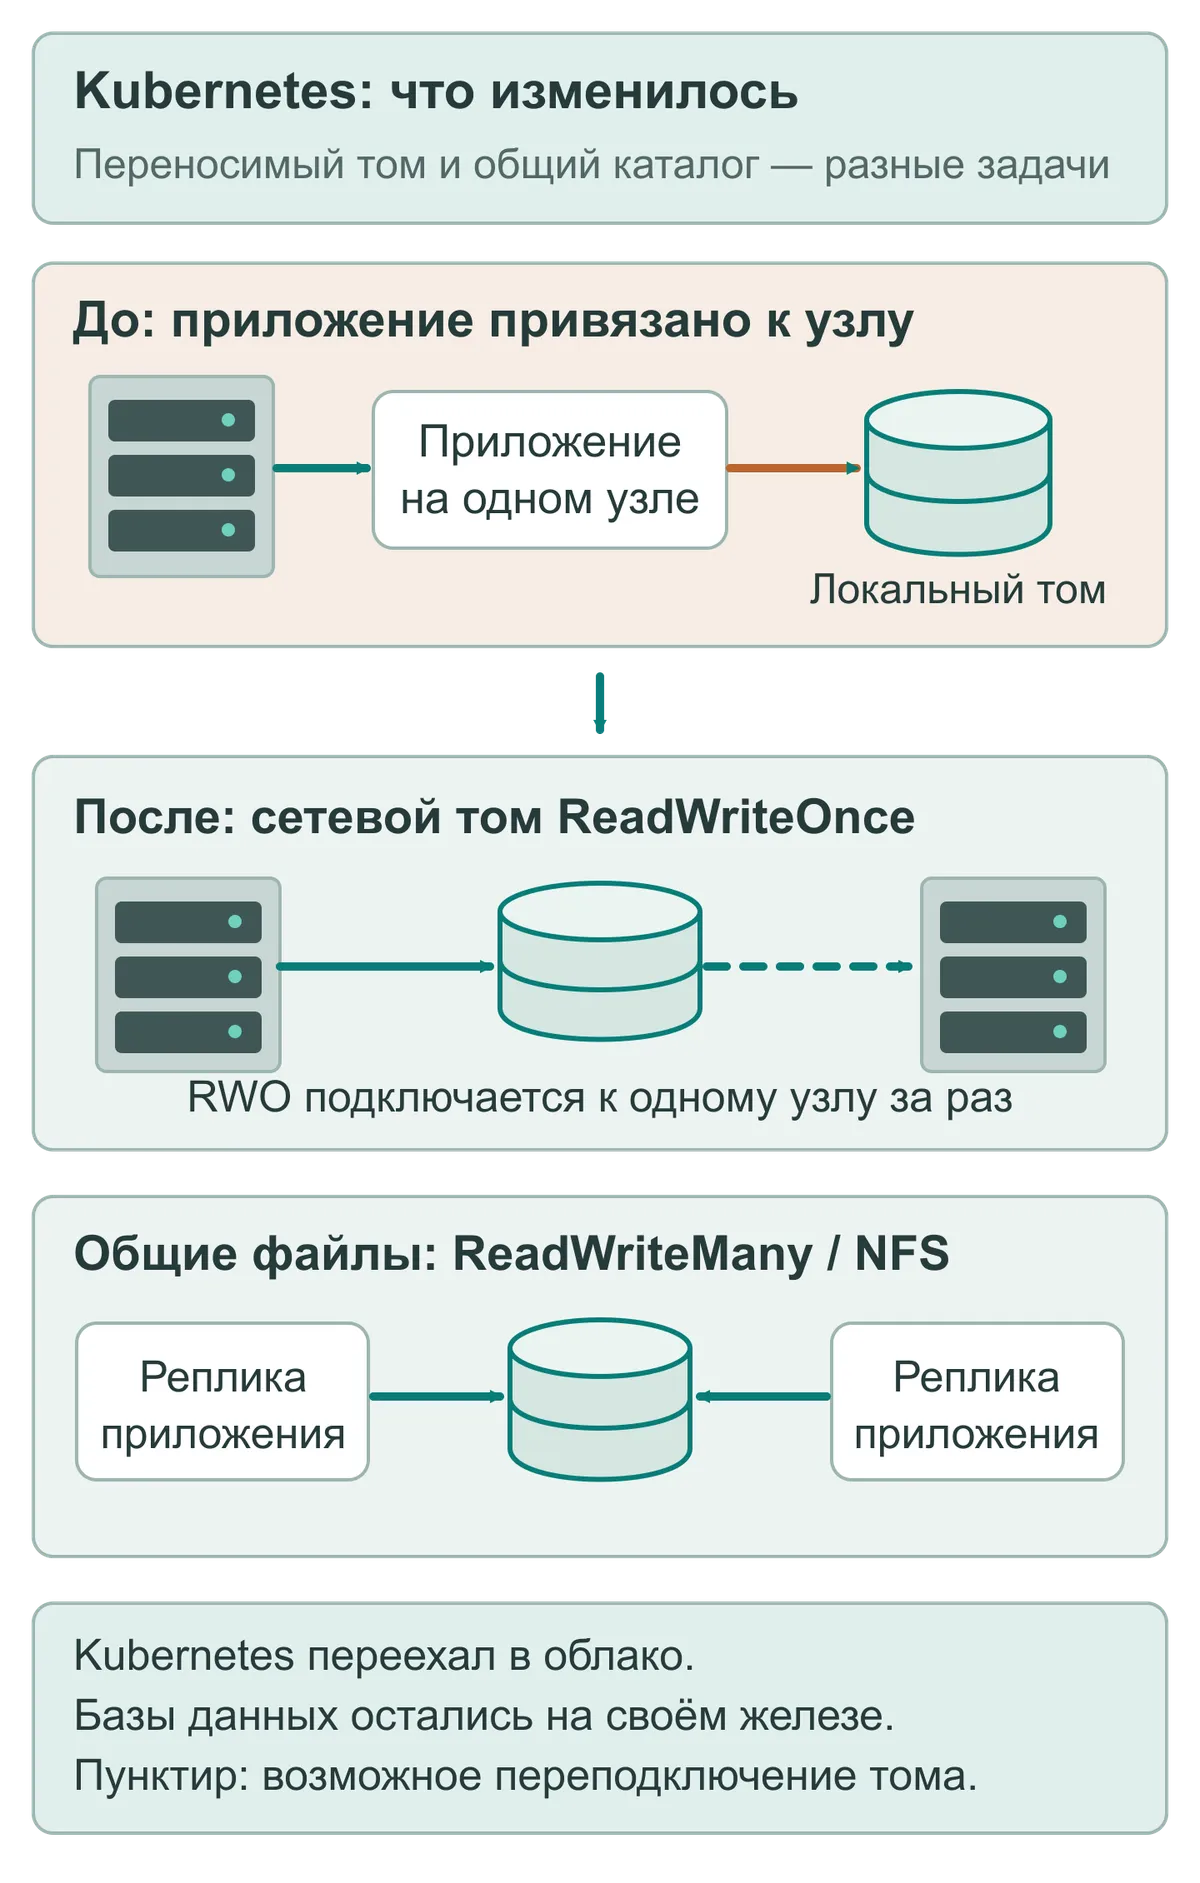
И у этой схемы была врождённая беда: общего хранилища не было. Диск приложения существовал только на том узле, где приложение запустилось. Из этого следовало всё остальное:
- часть служб была прибита к конкретным узлам — иначе они теряли свои данные при переезде;
- такую службу нельзя было запустить в двух копиях: вторая не увидела бы диск первой;
- отказ узла означал не «поды переехали», а простой всех прибитых к нему служб до его возвращения;
- обновление узла превращалось в согласованное окно работ вместо рутинной операции.
Автомасштабирование в такой схеме тоже бессмысленно: масштабировать нечего, если служба существует ровно в одном экземпляре на конкретной машине.
Часть первая: переезд
Кластер уехал в облако. Ключевое приобретение переезда — не чужие серверы вместо своих, а сетевое блочное хранилище: том больше не лежит на диске конкретной машины, а подключается к тому узлу, где оказался под.
Сняли привязки к узлам. Службы, прибитые к машинам ради своих дисков, отвязали: том едет за подом. Блочный том остаётся ReadWriteOnce — он подключается к одному узлу за раз, — но этого достаточно, чтобы под свободно переезжал, а обновление узла перестало быть окном работ.
Общие файлы вынесли туда, где их видят все реплики. Там, где нескольким копиям сервиса нужен один и тот же каталог — галереи, загрузки пользователей, sitemap, — тома переведены на ReadWriteMany поверх NFS. Это отдельная задача от переносимости диска, и решается она другим классом хранилища.
Развернули в несколько копий. Сервисы без собственного состояния поехали репликами на разных узлах; те, у кого состояние есть, получили по своему тому в StatefulSet. Отказ узла перестал быть простоем: нагрузка расходится по оставшимся.
Включили автомасштабирование. Число копий меняется по событиям — длине очередей и фактической нагрузке, а не по расписанию и не вручную.
Часть файлов вынесли в S3. Пользовательские файлы и статика перестали занимать блочные тома: доступ к ним не зависит от того, на каком узле оказался под, и место кончается не у сервиса, а у бюджета.
Базы остались на своём железе. Их не тащили в облако осознанно: у них другие требования к дискам и предсказуемости задержек. Отсюда и гибрид — кластер в облаке, базы и обслуживающие службы на площадке.
Что дал переезд
- Сервисы работают в нескольких копиях на разных узлах — отказ узла перестал быть простоем.
- Появилось автомасштабирование: число копий следует за нагрузкой, а не за догадками.
- Диск больше не привязывает службу к машине — обновление узла стало рутиной, а не окном работ.
Часть вторая: разобраться, как это устроено
Переезд решил задачу масштабирования, но не главную. Проблема была не в том, что что-то не работало. Проблема была в том, что никто не мог сказать, как именно оно работает. Документации не существовало, знания жили в головах людей, часть из которых уже ушла. Любое изменение превращалось в археологию, а любая авария — в гадание.
По ходу разбора выяснилось и остальное:
- часть служебной инфраструктуры — вход трафика, выпуск сертификатов, мониторинг — управлялась руками и в описании инфраструктуры не значилась;
- в репозитории лежали каталоги, которые никуда не применялись, а в кластере работали ресурсы, которых в репозитории не было;
- миграция балансировщиков была начата и брошена: внутренний трафик держал старый узел на снятой с поддержки системе;
- версия кластера отставала от актуальной на несколько выпусков;
- у нескольких критичных для платформы служб не было резерва — отказ одного экземпляра останавливал функцию целиком;
- реплика базы периодически отставала настолько, что штатно догнать главный сервер уже не могла;
- гибридная схема нигде не была описана целиком: в облаке знали про облако, на площадке — про площадку, а связность между ними и взаимные зависимости не держал в голове никто.
Инфраструктура, которую предстояло описать
В облаке:
- кластер Kubernetes — три управляющих узла и девять рабочих, два десятка пространств имён, около семидесяти томов, полтора десятка wildcard-сертификатов;
- около двухсот приложений: API, фоновые обработчики, сайты, служебные утилиты;
- очереди, кеши, полнотекстовый поиск, распределённая база в оперативной памяти;
- блочные тома под данные приложений средствами облачной платформы.
На своём железе:
- кластер виртуализации из трёх узлов и сервер резервного копирования;
- серверы баз данных вне кластера: MySQL в связке «главный сервер плюс реплика» через ProxySQL, PostgreSQL, аналитическая база;
- обслуживающие службы, без которых кластер не живёт: Git-репозиторий GitOps-доставки на FluxCD, Velero для резервных копий кластера, NFS-сервер под тома ReadWriteMany.
Поверх всего — доставка изменений через GitOps с автоматическим обновлением образов и сбор метрик и логов.
Что сделали
Инвентаризация. Прошли инфраструктуру снизу вверх и по обе стороны гибрида: железо и гипервизоры на площадке, виртуальные машины и кластер в облаке, приложения, базы, очереди, доступы. Каждый слой описан отдельным документом — от топологии узлов до карты всех приложений с их ролями и адресами публикации. Отдельно зафиксировано, что из облака ходит на площадку и наоборот: без этой карты любое отключение выглядит необъяснимым.
Сверка описанного с реальным. Отдельная работа: сопоставили то, что лежит в репозитории, с тем, что фактически крутится в кластере. Получился перечень расхождений: что развёрнуто мимо GitOps, что лежит в репозитории мёртвым грузом, какие тома остались от давно удалённых служб. Без правок — сначала факты, решения потом.
Инструкции на типовые операции. Пересборка отставшей реплики базы, откат выкатки, приостановка и возобновление доставки, восстановление кластера из резервной копии, аварийный доступ к железу в обход операционной системы. Каждая — по шагам, с проверками и путями отхода.
Разбор инцидента с репликацией. Описали не только последовательность восстановления, но и причину: почему штатное переподключение перестаёт работать после определённого порога отставания и как понять, что реплику уже нужно пересобирать, а не ждать.
Доступы. Навели порядок в удалённом доступе: отдельные контуры для администраторов и сотрудников, понятная схема выдачи и отзыва.
Результат
- Инфраструктура описана: четыре десятка документов вместо устных преданий.
- Скрытые риски выведены наружу и превратились в понятный список работ с приоритетами — вместо неприятных сюрпризов во время аварии.
- Типовые операции выполняются по инструкции, а не по памяти конкретного человека.
- Расхождения между кодом и реальностью зафиксированы, дальнейшая работа идёт от них.
Главное: платформа перестала быть чёрным ящиком. Уход любого участника больше не уносит с собой критичные знания.
Что дальше
Из списка находок собран план: обновление кластера, завершение миграции балансировщиков, перевод служебной инфраструктуры под GitOps, резервирование служб без запаса прочности. Работы идут по очереди, от самого рискованного к косметике.