Что находится при приёме чужой инфраструктуры
Прежде чем брать систему на обслуживание, мы её изучаем. Не ради формальности: подписать SLA на инфраструктуру, устройства которой не знаешь, — способ гарантированно нарваться. Ниже — реальный список находок по одной платформе. Она работала, пользователи были довольны, никто ничего не подозревал.
Что смотрели
SaaS-платформа: кластер Kubernetes из десяти узлов, около двадцати пяти микросервисов, очереди, кеши, поиск, публичные фронты. Возраст — почти пять лет. Разработка своя, эксплуатацией занимались по остаточному принципу.
Что нашли
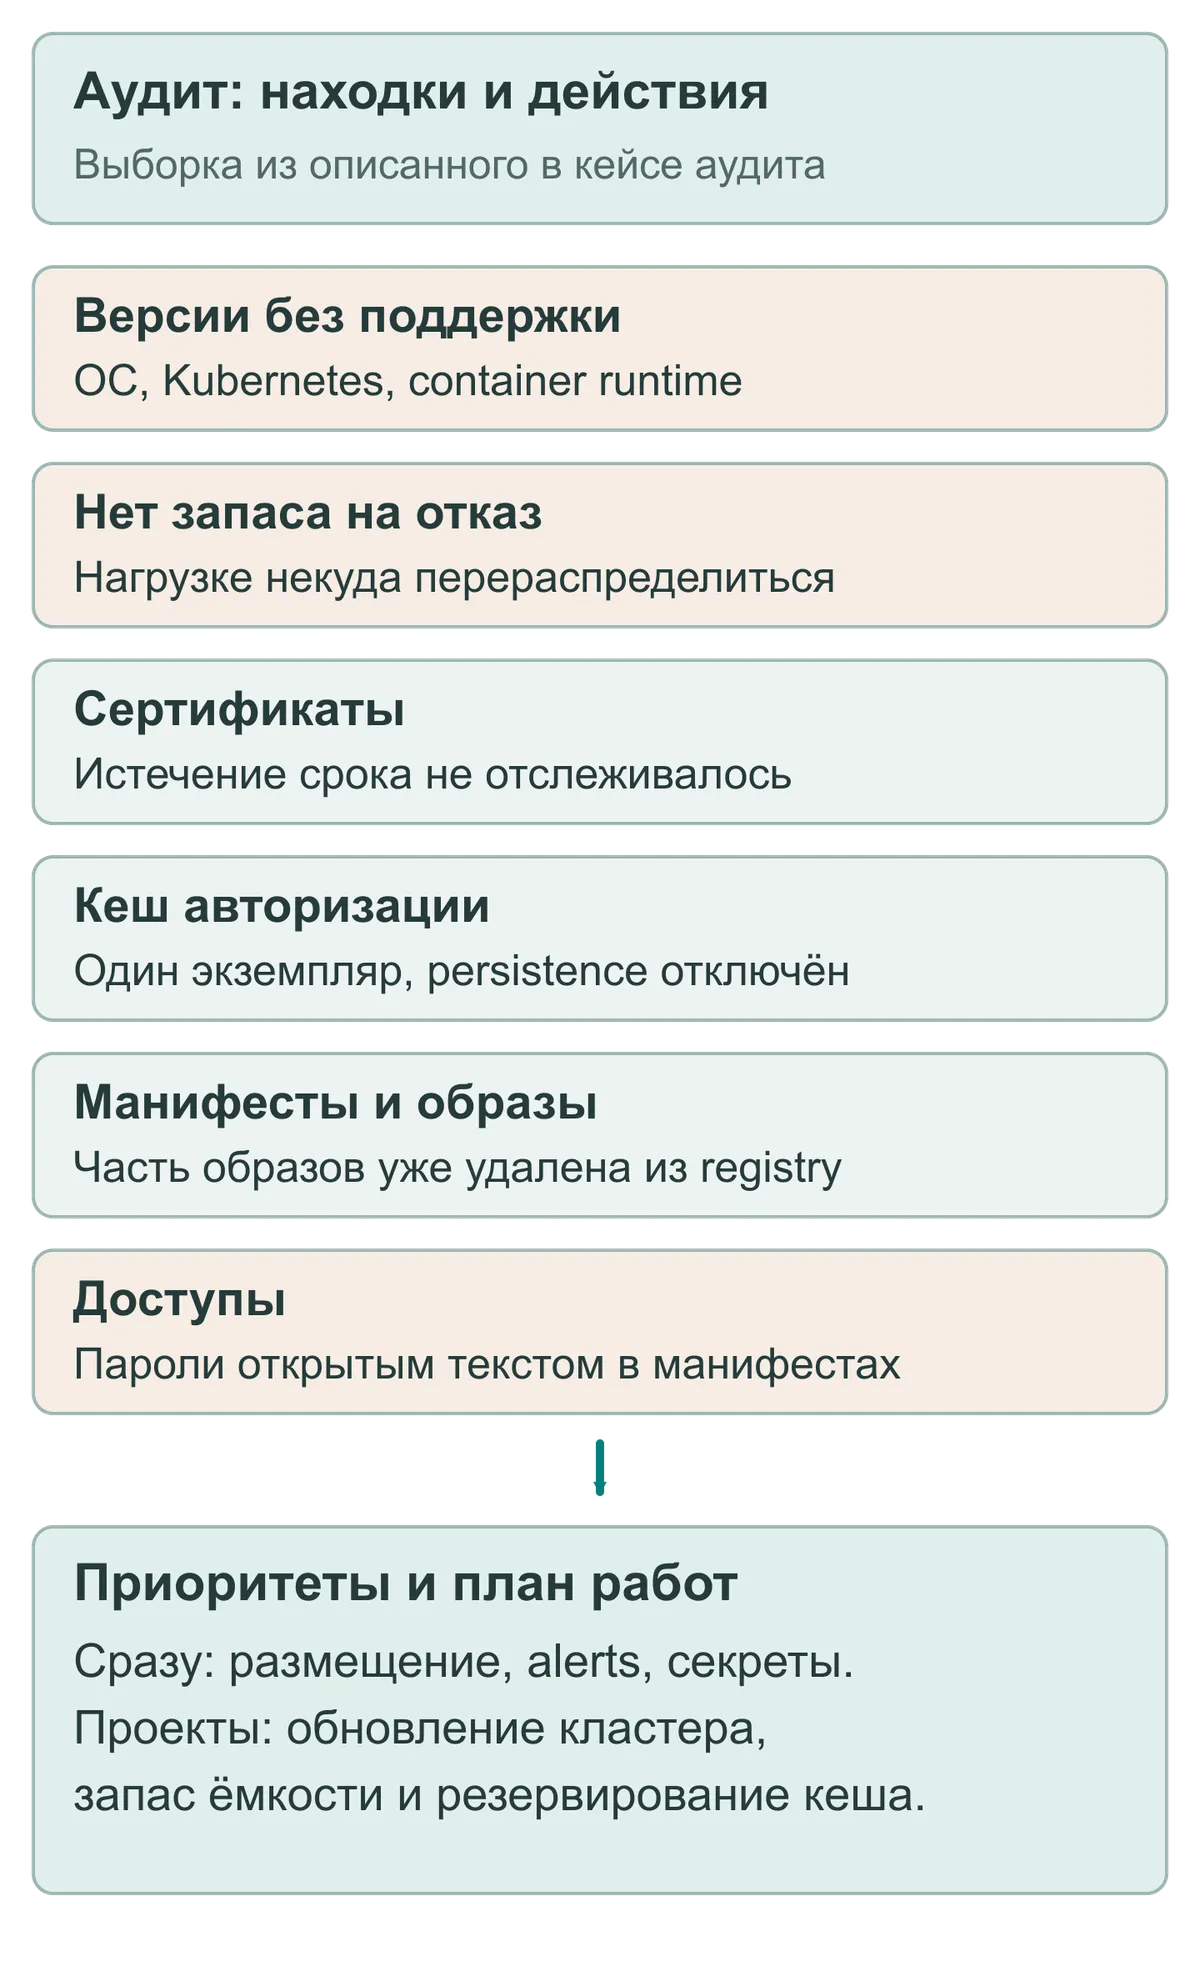
Версии, снятые с поддержки — всё сразу. Kubernetes отставал на три года от конца поддержки, container runtime — тоже, ОС на узлах — тоже. Исправления безопасности не приходят ни на один слой. Обновление такого кластера — это не «накатить пакет», а отдельный проект с последовательным переходом через промежуточные версии и заменой системы на узлах.
Нет запаса на отказ узла. Шесть рабочих узлов, загруженных так, что падение любого добавляет остальным пятую часть нагрузки — на пиках это выход за сто процентов. Хуже: часть служебных компонентов прибита nodeSelector к конкретным узлам, и при отказе такого узла они просто не переедут никуда.
Просроченный сертификат, который полгода пытался обновиться. cert-manager повторял выпуск каждые двадцать минут — накопилось почти семьсот неудач подряд, и никто этого не видел: alert на срок действия сертификатов не был настроен.
Сервис, который перезапускался каждые пять минут. descheduler выселял его поды: podAntiAffinity и topologySpreadConstraints были заданы так, что расставить их без нарушений не получалось. Отдельные поды жили чуть больше минуты. Снаружи это выглядело как случайные ошибки на части запросов — их списывали на «иногда бывает».
Кеш авторизации без резерва. Один экземпляр, без реплики и с отключённым persistence. Его падение означало разлогин всех пользователей разом и шторм запросов в базу на холодном старте.
Описание не совпадало с реальностью. В манифестах Deployment одного из компонентов были прописаны образы, которых больше нет в registry: производитель удалил их. Любое обновление этого компонента положило бы его насовсем — образ остался только на одном узле из десяти.
Память узла на 87 % при среднем в 55 %. Тренд рос полгода. Ещё один всплеск — и узел уходит в swap или прилетает OOM killer.
Пароли в открытом виде. Доступы к базе, очередям и кешу лежали открытым текстом в манифестах вместо Secret’ов и внешнего хранилища секретов. Любой, у кого есть право читать манифесты, видел их целиком; они же попадали во все выгрузки состояния кластера.
Что с этим делали
Все находки собраны в один документ и отсортированы по серьёзности — с оценкой последствий и предложением, что делать. Часть закрыли сразу: правила размещения, alert rules на срок действия сертификатов, перенос паролей в хранилище секретов. Часть превратилась в проекты со своими сроками: обновление кластера, добавление узла для запаса, резервирование кеша.
Главная ценность аудита не в списке, а в том, что после него разговор с заказчиком идёт предметно: вот риск, вот его цена, вот стоимость устранения. Дальше бизнес решает сам — но уже зная, за что платит и чем рискует.