Кластер виртуализации упёрся в память
Как это выглядит
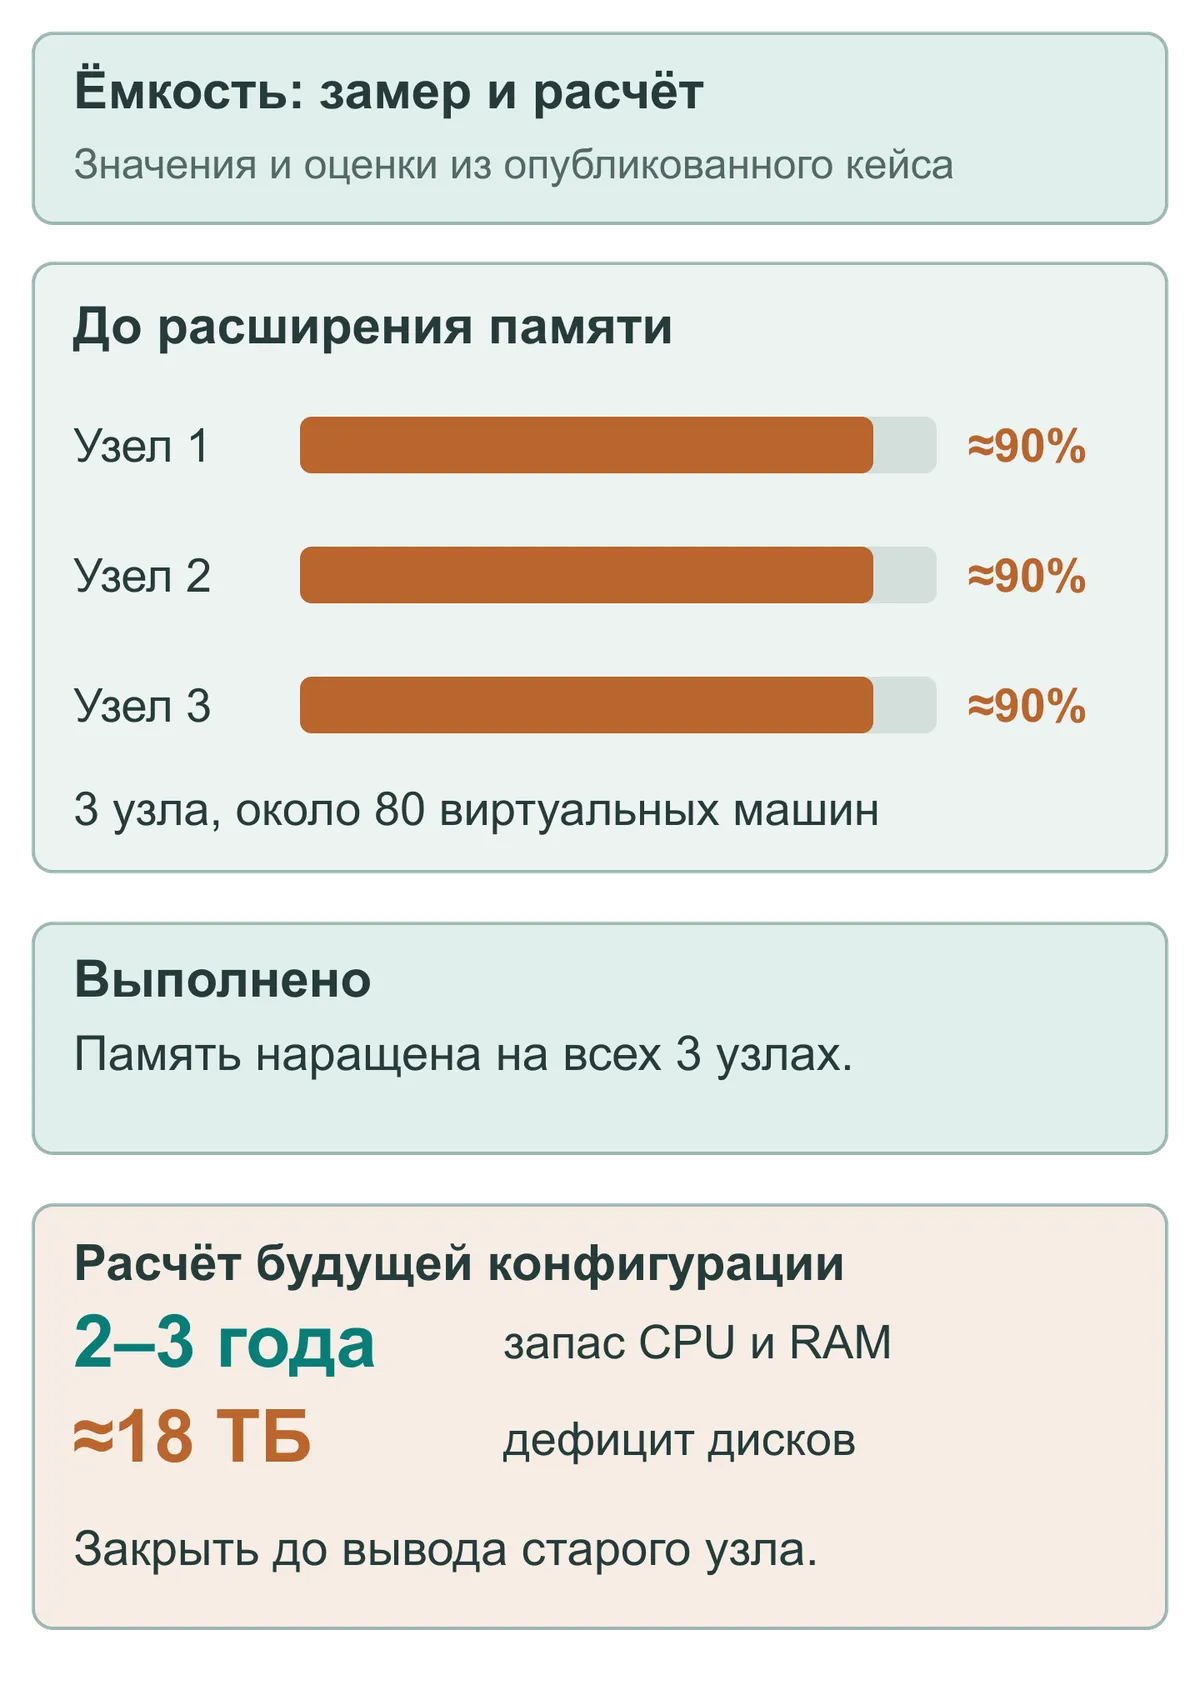
Заказчик приходит не со словами «нам не хватает памяти», а со словами «стало тормозить» и «не можем поднять ещё одну машину». Дальше — замеры, и картина проясняется: занятость памяти на всех трёх узлах кластера виртуализации держится около девяноста процентов, свободного места под новую нагрузку нет ни на одном.
Хозяйство при этом живое: около восьмидесяти виртуальных машин, разработка и продуктив рядом, отказаться от чего-нибудь нельзя.
Что сделали
Сняли фактическое состояние, а не то, что записано в документах. Обошли узлы, собрали данные напрямую: модели процессоров, установленная память, число и тип модулей, свободные слоты, занятость дисков, реальное потребление виртуальных машин против выделенного им. Отдельно — тренды за год из системы мониторинга: важно не мгновенное значение, а куда всё движется.
Учли, что серверы арендованные. Это меняет процедуру: память не покупается и не ставится своими руками, а заказывается у владельца площадки заявкой. Значит нужны точные идентификаторы железа, номера услуг и согласованное окно, а не «подойдём в выходные с планками».
Нашли ловушку в расчётах. Свободной памяти всегда меньше, чем кажется: к выделенному виртуальным машинам нужно прибавлять файловый кэш системы хранения, который занимает всё, до чего дотянется. На одном из узлов сумма выделенного и лимита кэша превышала физический объём — держалось только на том, что гости не выбирали выделенное, а кэш ужимался. Такую конструкцию нельзя расширять, не пересмотрев лимиты.
Нарастили память в окно. Учли неочевидное: один из узлов терминирует внешний канал связи, и его перезагрузка кладёт не только его виртуальные машины, но и удалённый доступ ко всей площадке. Окно согласовали с этим расчётом. Работы заняли около получаса, все три узла перезагружены, результат подтверждён историей метрик, а не словами.
Посчитали конфигурацию на будущее. Отдельная работа: что будет, если вывести самый старый узел, а оставшиеся довести до целевого объёма и добавить новый сервер. Расчёт по трендам за год показал: процессоров и памяти в такой конфигурации хватит на два-три года. А вот дискового пространства не хватит — дефицит около восемнадцати терабайт, и это надо закрывать до вывода старого узла, иначе кластер сразу окажется за восемьюдесятью процентами занятости.
Там же назвали риск, который в таблицах не виден: часть нагрузки 1С переезжает на процессоры, которые почти вдвое медленнее в однопоточных операциях. Для 1С это чувствительно, и лучше узнать об этом на бумаге, чем от пользователей после переезда.
Что получил заказчик
- Память на узлах, выросшую до рабочего запаса, — без сюрпризов во время работ.
- План развития кластера с цифрами: что менять, в каком порядке, что купить и когда именно упрётся снова.
- Названный заранее риск по производительности — с возможностью решить, что с ним делать, до переезда, а не после.